L’integrazione dei sistemi IT è la disciplina architetturale che collega applicazioni software, fonti dati e servizi eterogenei per farli funzionare come un unico sistema coerente. Trasforma un insieme di strumenti digitali isolati in un tutto unificato e realmente operativo. Senza una strategia di integrazione chiara, le aziende si ritrovano a gestire silos di dati, flussi manuali inefficienti e software fragili, difficili da mantenere.
Questa guida offre una panoramica pragmatica per founder, CTO e leader tecnici su come affrontare l’integrazione dei sistemi IT non come un compito tecnico accessorio, ma come una componente centrale di un’architettura digitale resiliente e scalabile.
Il problema: sistemi frammentati come collo di bottiglia per il business
In qualsiasi impresa moderna, il software non vive in isolamento. Il CRM deve scambiare dati con la piattaforma di marketing automation. Il sistema di fatturazione deve sincronizzarsi con l’ERP. Le piattaforme di analytics devono attingere a decine di sorgenti per generare insight realmente utili.
L’integrazione dei sistemi IT è la pratica ingegneristica che rende possibili, affidabili e sicuri questi collegamenti.
Considerare l’integrazione come una serie di attività tecniche ad hoc è un errore comune e costoso. Un ecosistema digitale frammentato genera attrito operativo che impatta direttamente sui risultati economici. Quando i sistemi non riescono a comunicare in modo programmatico, il personale è costretto a inserire dati manualmente, con conseguenti errori, calo di produttività e decisioni basate su informazioni obsolete o incomplete.
La soluzione: l’integrazione come livello architetturale strategico
Un approccio strategico all’integrazione crea una trama operativa unificata. I benefici sono concreti e supportano direttamente gli obiettivi di business fondamentali:
- Maggiore efficienza operativa: automatizzare i flussi di dati tra applicazioni elimina lavoro manuale ridondante e libera i team per attività che generano valore.
- Integrità dei dati più solida: sincronizzare i dati tra i sistemi stabilisce una single source of truth, garantendo che le decisioni aziendali si basino su informazioni accurate e coerenti.
- Maggiore agilità architetturale: un livello di integrazione progettato bene consente di aggiungere o sostituire applicazioni con impatto minimo, offrendo la flessibilità necessaria per adattarsi ai cambiamenti di mercato.
- Customer experience più coerente: collegare i sistemi di sales, supporto e prodotto offre una visione a 360 gradi del cliente, abilitando interazioni personalizzate e consistenti su tutti i touchpoint.
Un approccio ingenuo – limitarsi a collegare i sistemi quando serve – porta quasi inevitabilmente a un’architettura fragile e ingestibile. Il vero valore nasce dal trattare l’integrazione come una componente deliberata e fondativa della strategia digitale.
Le tendenze di mercato confermano quanto questa disciplina sia critica. Il mercato globale dell’integrazione dei sistemi è destinato a più che raddoppiare, passando da 360,705 miliardi di dollari nel 2019 a 708,747 miliardi di dollari entro il 2026, una crescita trainata dall’adozione del cloud e dall’IoT. Questo andamento evidenzia una realtà semplice per i leader tecnici: un’integrazione efficace è la spina dorsale di un’azienda resiliente e competitiva. Ulteriori approfondimenti sono disponibili nella ricerca di mercato completa su Business Wire.
Scegliere un’architettura di integrazione: un progetto per la scalabilità
Selezionare un’architettura di integrazione è come scegliere il progetto strutturale di un edificio. La decisione iniziale determina integrità strutturale, possibilità di evoluzione futura e costi di manutenzione nel lungo periodo. Una scelta miope produce un sistema fragile, difficile e costoso da modificare. La scelta giusta crea le basi per una vera agilità di business.
Ogni pattern di integrazione dei sistemi IT comporta compromessi in termini di complessità, costi e flessibilità. Capire questi compromessi è una responsabilità fondamentale per chiunque stia costruendo un ecosistema digitale connesso.
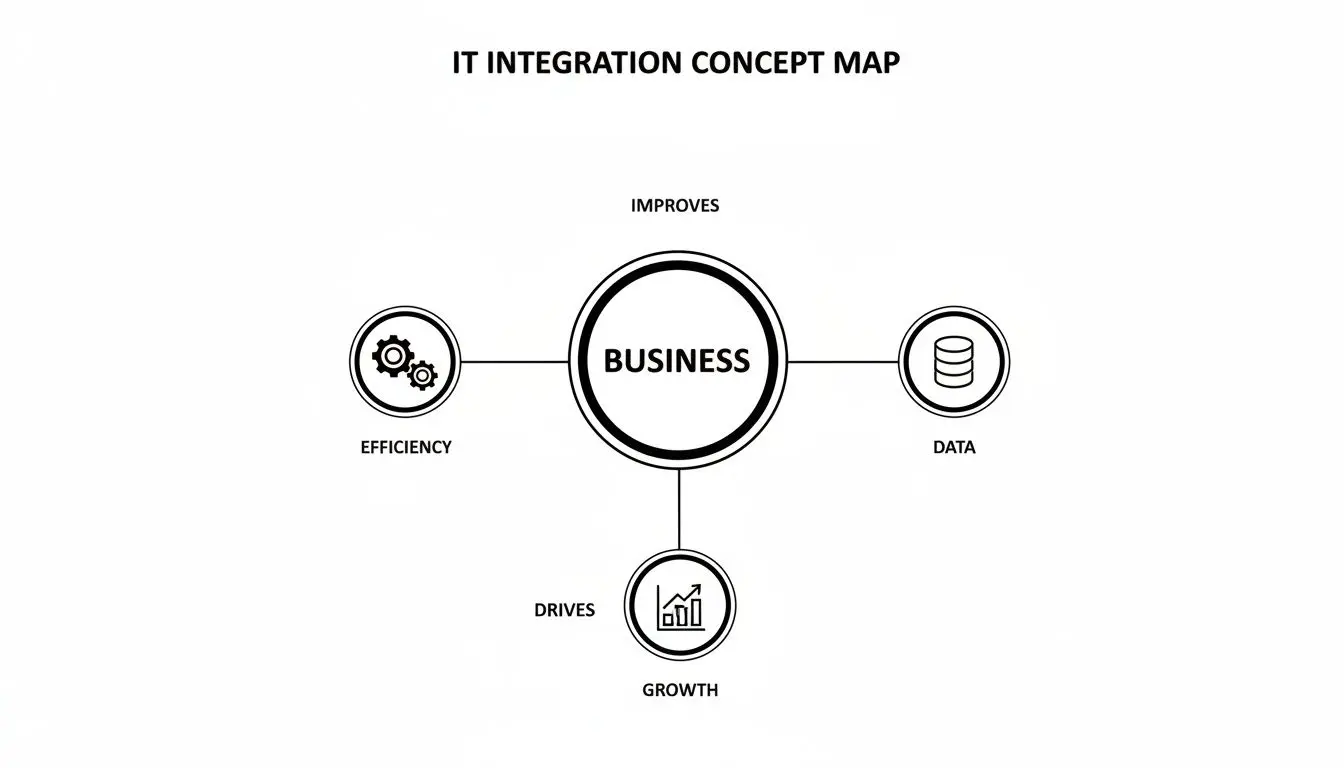
Questo diagramma mostra un principio chiave: l’integrazione non è un’attività periferica, ma il hub centrale che abilita risultati di business fondamentali come efficienza, coerenza dei dati e crescita.
Il rischio delle connessioni point-to-point
L’approccio di integrazione più elementare è la connessione point-to-point, in cui due sistemi sono collegati direttamente. Per un compito semplice e isolato, come connettere un CRM a un singolo strumento di marketing, questo metodo è rapido e lineare.
Ma questa semplicità è ingannevole. Quando il numero di sistemi cresce, il numero di connessioni point-to-point esplode in modo quadratico. Collegare solo cinque sistemi richiede dieci collegamenti separati, costruiti su misura. Il risultato è quasi sempre una “spaghetti architecture” – una rete aggrovigliata e non documentata di dipendenze, praticamente impossibile da debuggare, modificare o mettere in sicurezza. Ogni nuovo sistema aggiunto rende l’intera struttura esponenzialmente più fragile.
Un sistema basato su connessioni point-to-point è una bomba a orologeria di debito tecnico. Sacrifica la manutenibilità nel lungo periodo per la comodità nel breve, un compromesso che ripaga di rado.
I compromessi dei modelli centralizzati hub-and-spoke
Per rispondere al caos delle connessioni point-to-point, è emerso il modello hub-and-spoke, spesso implementato con un Enterprise Service Bus (ESB). In questo pattern, tutta la comunicazione passa attraverso un hub centrale che gestisce trasformazione dei dati, routing e traduzione dei protocolli.
Questo approccio introduce ordine. Invece di collegare ogni sistema a tutti gli altri, ogni applicazione richiede una sola connessione all’hub centrale. La gestione si semplifica e si ottiene un punto unico per monitoraggio e controllo. Tuttavia, questa centralizzazione introduce a sua volta nuovi problemi:
- Single point of failure: se l’hub centrale va in fault, ogni processo integrato dell’organizzazione si blocca.
- Collo di bottiglia prestazionale: con l’aumento dei volumi di dati e del numero di sistemi connessi, l’ESB può diventare un punto di congestione, degradando le prestazioni dell’intera architettura.
- Vendor lock-in e complessità: le soluzioni ESB sono spesso proprietarie, monolitiche e costose, e richiedono competenze specialistiche per manutenzione e gestione.
Il modello hub-and-spoke porta disciplina, ma spesso crea un collo di bottiglia monolitico che frena l’agilità.
Disaccoppiamento moderno con la connettività API-led
Un approccio più moderno e flessibile è la API-led connectivity. Questa strategia organizza le integrazioni in tre livelli distinti di API, trattando ogni integrazione come un prodotto gestito e riutilizzabile:
- System API: fungono da gatekeeper, offrendo accesso sicuro e coerente ai sistemi backend core, ad esempio database, ERP e piattaforme legacy. Espongono i dati senza rivelare la complessità dell’implementazione sottostante.
- Process API: sono gli orchestratori. Combinano i dati provenienti da più System API per eseguire uno specifico processo di business, come “elabora ordine cliente” o “onboard nuovo dipendente”.
- Experience API: sono il livello rivolto al consumatore. Impacchettano i dati delle Process API e li adattano a un canale utente specifico, che sia un’app mobile, un portale web o il sistema di un partner.
Questo design a livelli favorisce il riuso e disaccoppia i sistemi. Se un CRM viene sostituito, va aggiornato solo il System API corrispondente. Le Process API e le Experience API che consumano i dati cliente restano invariate, riducendo in modo significativo costi e rischi del cambiamento. Questo stile architetturale è un pilastro di approcci moderni come la Service-Oriented Architecture (SOA), che punta a costruire sistemi composti da servizi indipendenti e loosely coupled.
Confronto tra i principali pattern di integrazione IT
Il pattern migliore dipende dal contesto specifico, inclusi scala, competenze del team e obiettivi di business di lungo periodo. Non esiste una risposta universalmente “migliore”, ma solo quella più adatta al problema da risolvere.
| Pattern di integrazione | Ideale per | Vantaggio principale | Rischio principale |
|---|---|---|---|
| Point-to-Point | Integrazioni semplici tra due sistemi, con vita utile limitata. | Velocità. È il modo più rapido per collegare A a B quando serve una soluzione una tantum. | Complessità ingestibile. Genera una fragile “spaghetti architecture” impossibile da mantenere su larga scala. |
| Hub-and-Spoke (ESB) | Centralizzare il controllo in grandi imprese con molti sistemi legacy. | Governance centralizzata. Un punto unico per controllo, monitoraggio e applicazione delle policy. | Collo di bottiglia monolitico. L’hub centrale diventa un single point of failure e può ostacolare prestazioni e agilità. |
| API-Led Connectivity | Costruire una trama di integrazione scalabile, agile e riutilizzabile. | Disaccoppiamento e riuso. Favorisce l’agilità isolando i sistemi e trattando le integrazioni come prodotti riutilizzabili. | Investimento iniziale più alto. Richiede un impegno strategico su progettazione, gestione e governance delle API. |
L’obiettivo finale è costruire un sistema che possa evolvere con il business, non limitarlo. Questi pattern offrono percorsi diversi per raggiungere quel risultato, ciascuno con un equilibrio specifico tra velocità nel breve e resilienza nel lungo periodo.
Gestire i rischi critici dell’integrazione da una prospettiva ingegneristica
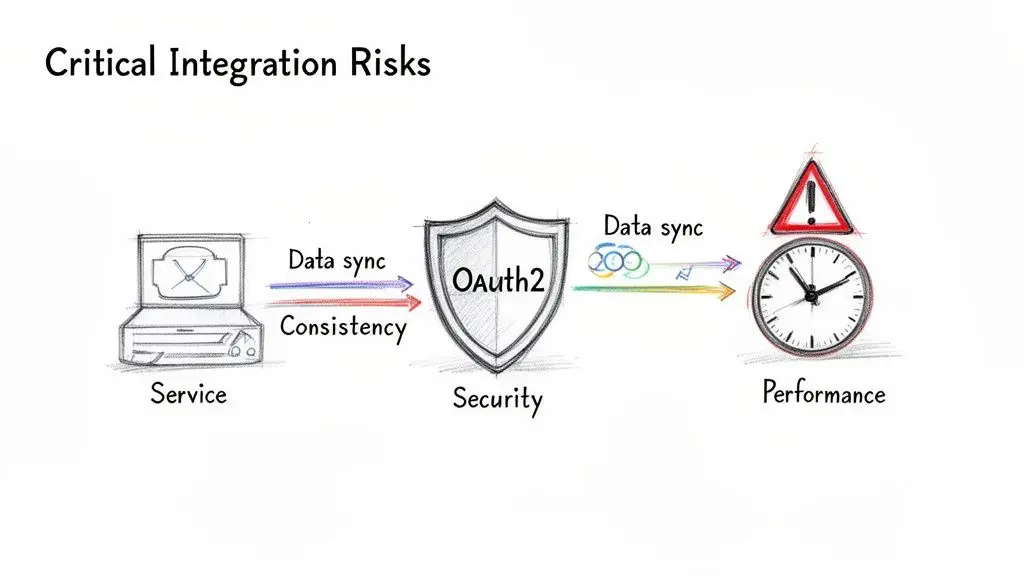
Collegare sistemi introduce nuovi rischi, spesso complessi. Un approccio superficiale all’integrazione dei sistemi IT può creare vulnerabilità di sicurezza catastrofiche, problemi di integrità dei dati e colli di bottiglia prestazionali in grado di bloccare le operazioni. Per le organizzazioni soggette a framework di compliance come GDPR, NIS2 e DORA, un’integrazione progettata male non è solo un fallimento tecnico – è una responsabilità aziendale e legale rilevante.
L’ampliamento della superficie di attacco
Ogni connessione tra sistemi crea un nuovo potenziale punto di ingresso per gli attaccanti. Le API, essendo il meccanismo principale dell’integrazione moderna, sono bersagli privilegiati se non vengono protette correttamente. Un’API implementata male può esporre dati sensibili o consentire azioni non autorizzate, trasformando una connessione funzionale in una grave vulnerabilità di sicurezza.
La sicurezza deve essere una considerazione architetturale fin dall’inizio, non un ripensamento successivo. Questo significa implementare protocolli standard e robusti per il controllo degli accessi.
- Autenticazione: verifica l’identità dell’entità che effettua la richiesta. Di solito si gestisce con API key nei casi semplici oppure, in modo più sicuro, con protocolli come OAuth 2.0, che consente accesso delegato senza condividere credenziali grezze.
- Autorizzazione: conferma che un’entità autenticata abbia i permessi necessari per eseguire l’azione richiesta. Implica l’applicazione del principio del privilegio minimo, assicurando che un servizio possa accedere solo ai dati e alle operazioni strettamente necessari.
Ignorare queste misure di sicurezza fondamentali è una negligenza architetturale. Non si tratta di chiedersi se avverrà una violazione, ma quando.
La sfida della coerenza dei dati nei sistemi distribuiti
Quando la stessa entità dati esiste in più sistemi, mantenere sincronizzazione e accuratezza diventa una sfida significativa. Per esempio, se un cliente aggiorna il proprio indirizzo in un portale di supporto ma la modifica non si propaga al sistema di fatturazione, il risultato sono pagamenti falliti e discontinuità operativa. Questa difficoltà nel mantenere una single source of truth è uno dei problemi centrali dell’integrazione.
Nei sistemi distribuiti, ottenere una consistenza forte e istantanea è spesso impraticabile o impossibile. Per questo motivo, gli architetti progettano spesso in ottica di eventual consistency. Questo modello riconosce un breve ritardo temporaneo prima che tutti i sistemi siano sincronizzati. La sfida architetturale consiste nel progettare il sistema in modo che funzioni correttamente durante questa inconsistenza transitoria e nel implementare meccanismi robusti di sincronizzazione dei dati (ad esempio code di messaggi, event sourcing) per ridurre al minimo la finestra di riconciliazione. È altrettanto fondamentale una solida strategia di disaster recovery nel cloud per garantire la resilienza dei dati.
Colli di bottiglia nelle prestazioni e guasti a cascata
Un’integrazione progettata male può degradare le prestazioni dell’intero stack tecnologico. Se un servizio in una catena integrata presenta latenze elevate, si genera un effetto a catena che rallenta tutte le applicazioni dipendenti. Una singola API lenta può peggiorare l’esperienza utente su un intero prodotto.
Un rischio ancora più serio è quello dei guasti a cascata, in cui il cedimento di un componente innesca un effetto domino che porta giù i sistemi dipendenti. Per esempio, il malfunzionamento di un servizio di autenticazione centralizzato potrebbe impedire l’accesso degli utenti a tutte le applicazioni che lo utilizzano.
Mitigare questi rischi di prestazioni e affidabilità richiede pattern architetturali deliberati:
- Timeout: garantire che una chiamata verso un servizio lento o non reattivo non blocchi all’infinito l’applicazione richiedente.
- Circuit Breaker: sospendere automaticamente le richieste verso un servizio in errore per un intervallo definito, consentendogli di recuperare e impedendo che il guasto si propaghi.
- Comunicazione asincrona: utilizzare strumenti come le code di messaggi per disaccoppiare i sistemi, consentendo loro di comunicare senza richiedere una risposta immediata. Questo rende l’architettura complessiva più resiliente e reattiva.
Una roadmap agile per l’implementazione
I progetti di integrazione di sistemi IT di successo vengono raramente realizzati con una metodologia waterfall rigida e “big bang”. La complessità intrinseca e il rischio sono troppo elevati. Un approccio pragmatico e agile, che dia priorità a rilascio incrementale, feedback continuo e riduzione del rischio, è molto più efficace. Questo framework guida un progetto tecnico complesso dal concept iniziale fino a un sistema affidabile e manutenibile.
Fase 1: Discovery e progettazione architetturale
Questa fase iniziale è dedicata a un’analisi approfondita. Prima di scrivere una riga di codice, è essenziale capire quali sistemi sono coinvolti, quali dati devono fluire tra loro e quale logica di business governa questi flussi. Costruire senza questa chiarezza è una ricetta per il fallimento. Gli output di questa fase di discovery orientano direttamente la progettazione architetturale, dove si prendono le decisioni fondamentali su pattern di integrazione, stack tecnologici e implementazione della sicurezza.
Le attività chiave includono:
- Mappatura dei sistemi: documentare ogni sistema da integrare, incluse API, modelli dati e protocolli di comunicazione.
- Diagrammi dei flussi dati: creare rappresentazioni visive chiare di come i dati si spostano, dove avvengono le trasformazioni e cosa innesca ciascun processo.
- Threat modeling della sicurezza: identificare in modo proattivo le vulnerabilità potenziali nell’architettura proposta e definire strategie di mitigazione, come l’applicazione di OAuth 2.0.
- Selezione del pattern: scegliere il blueprint architetturale più adatto (ad esempio API-led, event-driven) in base ai requisiti di scalabilità, latenza e resilienza.
Fase 2: Rilascio incrementale e test completi
Con un piano architetturale solido, il focus passa all’esecuzione. Invece di cercare di costruire l’intera soluzione in una sola volta, il progetto viene consegnato in piccoli sprint iterativi. Ogni sprint si concentra sullo sviluppo e sul rilascio di una porzione distinta di funzionalità, come la sincronizzazione dei dati dei clienti tra due sistemi.
Questo ciclo iterativo fornisce feedback rapidi, consentendo al team di adattare e rifinire la soluzione man mano che acquisisce nuove informazioni. Questo approccio è supportato al meglio da una forte automazione, come descritto nella nostra guida alla creazione di una pipeline CI/CD moderna.
Ogni incremento deve essere validato da una strategia di test rigorosa:
- Test unitari e di integrazione: verificare che i singoli componenti e le loro connessioni dirette funzionino come previsto.
- Test end-to-end (E2E): simulare flussi utente reali per assicurarsi che l’intero processo integrato funzioni correttamente.
- Test di performance e di carico: stressare il sistema per individuare e risolvere i colli di bottiglia prima che impattino gli utenti in produzione.
Un pattern di fallimento frequente è rimandare i test completi fino alla fine del progetto. È una ricetta per il disastro, perché garantisce che i difetti architetturali più profondi emergano solo quando sono più costosi e difficili da correggere.
Fase 3: Monitoraggio e manutenzione continui
Un’integrazione non è “finita” al momento del deployment. Quello è solo l’inizio della sua vita operativa. Il vero lavoro consiste nel definire processi solidi di monitoraggio e manutenzione per garantire che il sistema resti sano, performante e sicuro nel lungo periodo. Questa pratica si chiama observability e si basa su tre pilastri:
- Logging: acquisire log dettagliati e strutturati da ogni componente per tracciare gli eventi e diagnosticare gli errori.
- Metriche: raccogliere indicatori chiave di performance (ad esempio tempi di risposta delle API, tassi di errore, profondità delle code) per offrire una vista in tempo reale dello stato di salute del sistema.
- Tracing: usare il distributed tracing per seguire una singola richiesta mentre attraversa più servizi, così da individuare con precisione l’origine esatta di una latenza o di un guasto.
Questa supervisione continua consente di passare da un modello reattivo di tipo “break-fix” a un modello proattivo, in cui i problemi potenziali vengono identificati e affrontati prima che diventino criticità importanti.
Integrazione dei sistemi AI: la nuova frontiera architetturale
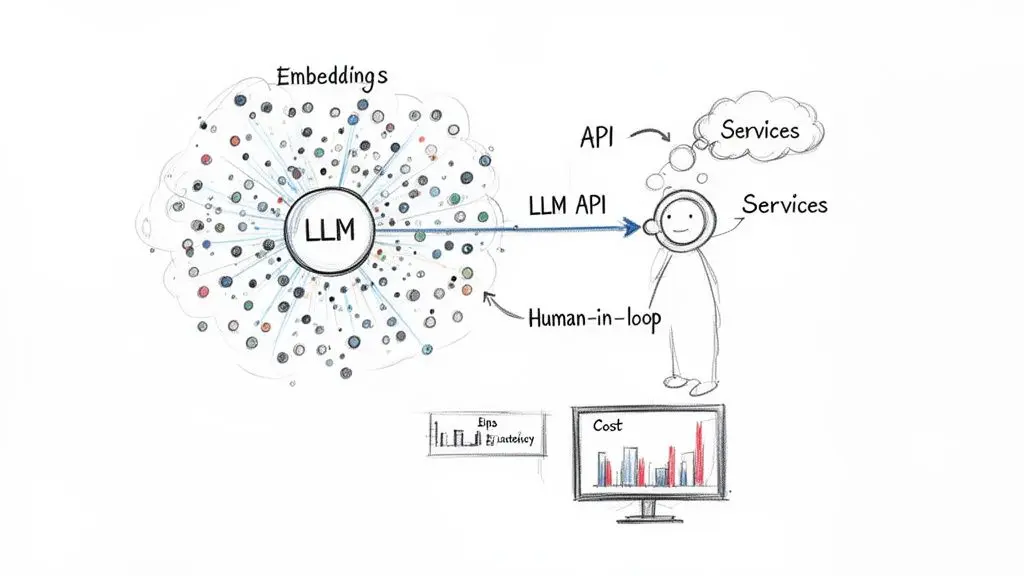
Integrare l’AI, in particolare i Large Language Models (LLM), introduce un livello di complessità che i playbook tradizionali di integrazione di sistemi IT non coprono. Collegarsi a un LLM via API è semplice, ma la vera sfida ingegneristica sta nel costruire l’architettura circostante necessaria per rendere questi sistemi affidabili, sicuri ed economicamente sostenibili. Questo implica orchestrare sistemi intrinsecamente non deterministici.
Orchestrare workflow agentici
Molte applicazioni AI avanzate si basano su workflow agentici, in cui un modello AI utilizza strumenti esterni (ad esempio interrogare un database, chiamare un’altra API) per completare un’attività complessa. Questo richiede un livello di orchestrazione sofisticato per gestire processi multi-step, governare la logica di tool-calling e recuperare dai guasti. A differenza di un microservizio standard con risposte prevedibili, un agente basato su LLM può produrre output inattesi o fallire in modi nuovi. Un’integrazione semplice che inoltra solo le richieste a un modello è fragile per definizione.
La necessità di guardrail robusti
Poiché gli output degli LLM sono probabilistici e generativi, sono intrinsecamente imprevedibili. I guardrail sono meccanismi di sicurezza essenziali che governano il comportamento del modello. Sono componenti critici dell’integrazione, non funzionalità opzionali.
I guardrail servono a:
- Prevenire contenuti dannosi: bloccare risposte inappropriate, distorte o non sicure.
- Garantire accuratezza fattuale: validare gli output rispetto a fonti dati affidabili per mitigare le “hallucination”.
- Mantenere la voce del brand: assicurare che tono e stile del modello siano allineati alle linee guida aziendali.
- Proteggere i dati sensibili: impedire che il modello esponga informazioni personali identificabili (PII) o altri dati riservati.
Un’integrazione AI senza guardrail è una responsabilità non governata. Espone il business all’intero spettro dei possibili guasti del modello, senza alcuna rete di sicurezza architetturale.
Questa esigenza di infrastrutture sicure e avanzate si riflette nei dati di mercato. Il mercato globale dell’integrazione di sistemi è previsto in crescita fino a 1.289,22 miliardi di dollari entro il 2032, trainato in larga parte dalla necessità di unificare i sistemi IT per migliorare agilità e sicurezza – una tendenza che supporta direttamente l’integrazione di sistemi AI complessi. Puoi approfondire le analisi di mercato di SkyQuest.
Observability dell’AI e supervisione umana
I sistemi AI richiedono una forma specializzata di monitoraggio, nota come AI observability. Questa va oltre le metriche standard di performance per tracciare fattori specifici dei modelli generativi, ed è fondamentale per mantenere sia l’affidabilità sia l’efficienza economica.
Le metriche principali da monitorare includono:
- Gestione dei costi: monitorare l’uso dei token per ogni chiamata API per evitare sforamenti di budget.
- Monitoraggio delle prestazioni: misurare la latenza e implementare strategie di fallback quando un modello primario è lento o non disponibile.
- Reliability engineering: usare la cache per ridurre i costi e il rate limiting per gestire le quote API.
Infine, per decisioni ad alto impatto, l’automazione deve essere bilanciata dal giudizio umano. Implementare controlli human-in-the-loop (HITL) è un pattern di integrazione essenziale. HITL garantisce che, per attività critiche – come autorizzare una transazione finanziaria di importo elevato o approvare una diagnosi medica – un esperto umano validi la raccomandazione dell’AI prima che venga eseguita. Questo approccio pragmatico unisce la velocità dell’automazione alla responsabilità della supervisione umana.
Conclusione: takeaway chiave per i leader tecnici
Trasformare la teoria dell’integrazione in un sistema affidabile e manutenibile che generi valore di business è una sfida ingegneristica importante. Il successo non si ottiene con un unico go-live su larga scala, ma attraverso un processo deliberato e iterativo guidato da solidi principi architetturali.
Principi fondamentali per una strategia di integrazione solida
Una strategia di integrazione robusta si fonda su quattro principi chiave che aiutano a evitare le trappole tipiche dei sistemi fragili e dei costi di manutenzione in crescita.
- Partire dal problema di business: l’integrazione deve servire a uno scopo chiaro, ad esempio automatizzare un workflow critico o creare una vista unificata del cliente. Evitare un approccio technology-first, in cui lo strumento viene scelto prima che il problema sia definito in modo completo.
- Progettare per la manutenibilità: la soluzione più veloce oggi spesso genera il debito tecnico più pesante domani. Dare priorità a pattern di integrazione come l’API-led connectivity, che favoriscono disaccoppiamento e riusabilità, anche se richiedono più investimento iniziale.
- Integrare sicurezza e privacy by design: la sicurezza non è una funzionalità da aggiungere in seguito. Deve essere parte fondante dell’architettura e includere autenticazione, autorizzazione e protezione dei dati per rispettare framework come il GDPR e prevenire violazioni costose.
- Rilasciare in modo incrementale: costruire, testare e distribuire le integrazioni in piccoli incrementi gestibili. Questa metodologia agile riduce il rischio, accelera i cicli di feedback e consente all’architettura di evolvere senza richiedere rebuild completi.
Il mercato degli system integrator è previsto in crescita da 595 miliardi di dollari nel 2026 a 1.900 miliardi di dollari entro il 2033. Questa crescita riflette l’enorme domanda di partner in grado di costruire soluzioni robuste e manutenibili, soprattutto in domini complessi come l’AI. Puoi approfondire qui la crescita del mercato degli system integrator. Per founder e CTO, la direzione è chiara: trattare l’integrazione come una competenza architetturale centrale. Prima di avviare un nuovo progetto, è fondamentale svolgere una fase di discovery accurata per mappare i flussi dati e definire gli obiettivi di business. Questo approccio disciplinato è la base per costruire un ecosistema digitale connesso, in grado di generare valore duraturo.
Domande frequenti sull’integrazione dei sistemi
Come si calcola il ROI di un progetto di integrazione?
Calcolare il ritorno sull’investimento di un progetto di integrazione significa quantificare i risultati di business oltre i costi iniziali di sviluppo. Una corretta analisi del ROI dovrebbe includere:
- Risparmio sui costi del lavoro: misurare le ore recuperate automatizzando l’inserimento manuale dei dati e i workflow, moltiplicate per il costo di quel lavoro.
- Risparmio da riduzione degli errori: quantificare l’impatto economico degli errori causati da dati non allineati, come fatture errate, sbagli nelle spedizioni o sanzioni di compliance.
- Guadagni di velocità dei processi: misurare la riduzione dei tempi di ciclo dei processi core di business (ad esempio, order-to-cash). Cicli più rapidi spesso si traducono in un migliore cash flow e in una maggiore soddisfazione del cliente.
Il vero ROI è la combinazione di questi risparmi quantitativi e del valore strategico dato da maggiore agilità e affidabilità dei dati.
Qual è la differenza tra una API e un’integrazione?
Una API (Application Programming Interface) è uno strumento; un’integrazione è il sistema funzionale costruito usando quello strumento.
Pensate a una API come a un contratto standardizzato che definisce in che modo un software può richiedere servizi o dati a un altro. È l’insieme di regole per la comunicazione.
Un’integrazione è il processo completo, end-to-end, che usa una o più API per connettere i sistemi e automatizzare un workflow. Per esempio, una singola integrazione di “onboarding di un nuovo cliente” potrebbe usare le API di un CRM, di una piattaforma di billing e di uno strumento di email marketing per creare un processo automatizzato fluido.
Conviene sviluppare un’integrazione custom o usare una soluzione iPaaS?
La scelta tra una soluzione custom e una Integration Platform as a Service (iPaaS) dipende dai requisiti specifici, dalle capacità del team e dalla strategia di lungo periodo.
- Sviluppo custom: questo approccio è adatto a workflow altamente specializzati, trasformazioni dati complesse o quando serve un controllo assoluto su performance, sicurezza e percorso dei dati. Offre la massima flessibilità, ma richiede risorse ingegneristiche importanti per lo sviluppo e la manutenzione continua.
- Uso di iPaaS: una soluzione iPaaS (ad esempio, MuleSoft, Zapier) eccelle nel connettere piattaforme SaaS diffuse grazie a connettori già pronti e builder visuali per i workflow. Accelera lo sviluppo nei casi d’uso standard, ma può introdurre limiti in termini di flessibilità, controllo e costi su larga scala.
In Devisia, progettiamo integrazioni custom robuste e manutenibili, allineate con la logica di business e i principi architetturali del cliente. Per noi, le integrazioni critiche vanno trattate come prodotti di prima classe, pensati per resistere nel tempo e generare valore duraturo.
Se siete pronti a passare da sistemi frammentati a un’architettura digitale unificata, parliamone. Per saperne di più sul nostro approccio, visitate https://www.devisia.pro.