Il disaster recovery nel cloud non consiste semplicemente nel fare backup dei dati. È una disciplina architetturale che garantisce che l’intera operatività digitale – applicazioni, infrastruttura e dati – possa essere ripristinata in modo prevedibile e affidabile dopo un guasto catastrofico. Questa responsabilità è condivisa: il cloud provider garantisce la propria infrastruttura, ma il ripristino delle applicazioni e dei dati costruiti sopra di essa resta a carico vostro.
Questa guida offre un framework pragmatico per CTO, architetti e responsabili engineering, così da progettare, implementare e validare una strategia di disaster recovery solida, allineata agli obiettivi di business e alle realtà tecniche.
Ripensare il Disaster Recovery come un vincolo architetturale
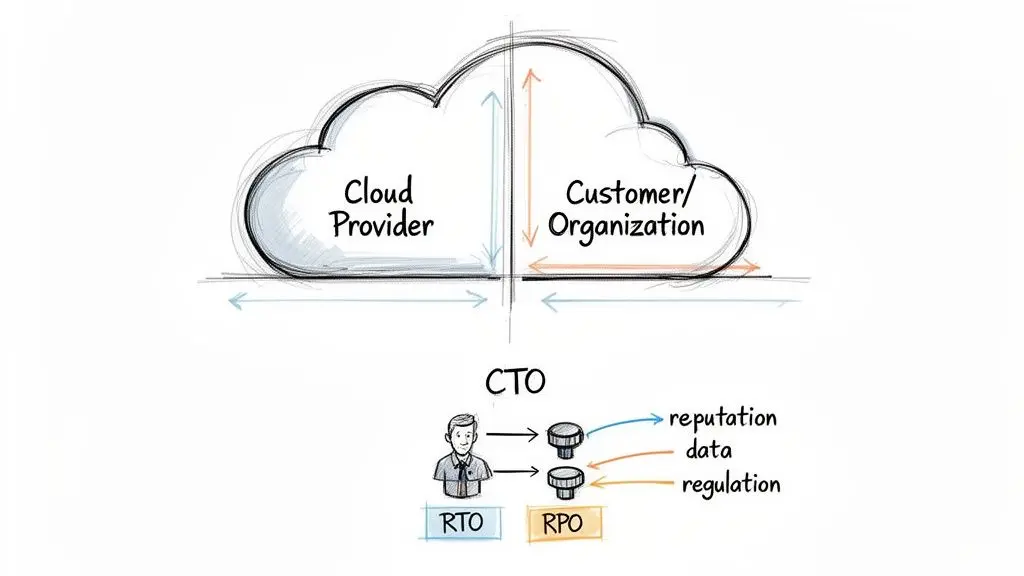
Un errore comune, e pericoloso, è pensare che i cloud provider gestiscano il disaster recovery end-to-end. Questa convinzione nasce da una comprensione errata del modello di responsabilità condivisa. Provider come AWS o Azure garantiscono la resilienza della propria infrastruttura globale – data center, networking, hardware fisico – ma la vostra organizzazione resta responsabile di tutto ciò che si appoggia su quella base. Questo include applicazioni, dati, configurazioni e policy di accesso.
Se una regione cloud va fuori servizio o uno script di deployment difettoso corrompe un database critico, l’obbligo del provider è ripristinare i propri servizi. Non è sua responsabilità recuperare la vostra applicazione specifica o i dati persi. Quella responsabilità ricade interamente sui team engineering e operations.
Da checklist IT a priorità di business
Trattare il disaster recovery come una casella da spuntare per la compliance è un grave errore strategico. Per la leadership tecnica e di prodotto, non implementare un piano DR robusto si traduce direttamente in rischi di business molto seri:
- Danno reputazionale: Ogni minuto di downtime erode la fiducia dei clienti, e recuperarla è difficile e costoso.
- Perdita irreversibile di dati: Senza una strategia di recovery solida, dati critici di business e degli utenti possono andare persi in modo permanente.
- Sanzioni normative: Framework emergenti come DORA (Digital Operational Resilience Act) nel settore finanziario e la direttiva NIS2 per le infrastrutture critiche impongono requisiti stringenti di resilienza, con sanzioni rilevanti in caso di mancata conformità.
La realtà operativa è che il recupero spesso non è completo. Le statistiche recenti sul disaster recovery mostrano che una percentuale significativa di organizzazioni non riesce a recuperare tutti i dati dopo un incidente, evidenziando un divario critico tra pianificazione ed esecuzione. Il problema è particolarmente evidente nei dati SaaS, dove i tempi di ripristino restano spesso molto lontani dalle aspettative del business.
Definire gli obiettivi di recovery come decisioni di business
Al centro di qualsiasi strategia di disaster recovery efficace ci sono due metriche chiave. Non si tratta solo di parametri tecnici: sono decisioni di business fondamentali, con impatti architetturali diretti.
Recovery Time Objective (RTO): qual è la durata massima accettabile di indisponibilità del servizio prima che l’impatto sul business diventi inaccettabile?
Recovery Point Objective (RPO): qual è il volume massimo di perdita di dati che il business può tollerare, misurato nel tempo a partire dal momento del guasto?
Un RTO di pochi minuti richiede un’architettura altamente automatizzata e già predisposta, molto più costosa di una soluzione che supporta un RTO di 24 ore. Allo stesso modo, un RPO prossimo allo zero richiede replica sincrona dei dati, una sfida ingegneristica non banale e con un impatto importante su prestazioni e costi. Questi obiettivi non sono interruttori da attivare, ma la traduzione diretta della tolleranza del business verso downtime e perdita di dati.
Questa guida illustra i pattern architetturali e le considerazioni implementative per costruire sistemi resilienti, efficaci e allo stesso tempo sostenibili nei costi. Per ulteriori approfondimenti, il nostro confronto tra infrastruttura cloud e on-premise offre una panoramica di base.
Tradurre i bisogni di business in metriche ingegneristiche
Prima di progettare un’architettura di disaster recovery, bisogna tradurre i requisiti di business in target ingegneristici misurabili. Recovery Time Objective (RTO) e Recovery Point Objective (RPO) sono le metriche di riferimento che determinano complessità, architettura e costo della strategia DR.
L’RTO definisce il downtime massimo accettabile. L’RPO definisce la massima perdita di dati accettabile. Le risposte a queste due domande – “Per quanto tempo possiamo restare offline?” e “Quanti dati possiamo perdere?” – guidano tutte le decisioni tecniche successive.
Recovery Time Objective (RTO) spiegato
RTO è il tempo obiettivo entro il quale un processo di business deve essere ripristinato dopo un disastro, per evitare conseguenze inaccettabili sulla continuità operativa. Il timer parte nel momento del guasto e si ferma quando il servizio torna pienamente operativo per gli utenti.
L’RTO riflette in modo diretto l’impatto sul business. Un’API di pagamento rivolta ai clienti può richiedere un RTO di pochi minuti, perché ogni secondo di downtime si traduce in perdita di fatturato e fiducia. Al contrario, un sistema interno di elaborazione batch può tollerare un RTO di diverse ore senza generare disservizi rilevanti.
Un RTO basso (minuti) richiede un’automazione estesa e un’infrastruttura già pronta al failover. Un RTO più alto (ore) può consentire un processo di ripristino manuale, ben documentato.
Recovery Point Objective (RPO) spiegato
RPO definisce il periodo massimo tollerabile in cui i dati potrebbero andare persi da un servizio IT a causa di un incidente grave. È il delta tra l’ultima copia consistente dei dati e il momento del guasto.
Un RPO di un’ora implica la possibile perdita di fino a un’ora di dati. Un RPO prossimo allo zero, cioè nessuna perdita di dati è accettabile, richiede replica sincrona dei dati – una soluzione tecnicamente complessa e costosa, che impatta la latenza in scrittura.
Applicare RTO e RPO nella pratica
Non tutti i sistemi hanno la stessa importanza. Applicare obiettivi DR aggressivi in modo uniforme a tutte le applicazioni è un uso inefficiente delle risorse. Un approccio più pragmatico consiste nel classificare i servizi in base alla loro criticità, definita insieme agli stakeholder di business.
Considerate questi due sistemi molto diversi:
- Database transazionale e-commerce: essendo il sistema di riferimento per ordini e pagamenti, è un servizio di primo livello. Il business richiederà un RTO e un RPO prossimi allo zero. La perdita di dati non è accettabile e il servizio deve essere ripristinato quasi istantaneamente per evitare perdite di fatturato. Questo requisito giustifica un’architettura active-active o warm standby.
- Dashboard di analytics: questo sistema interno elabora i dati durante la notte. Può tollerare un RPO di 24 ore, perché i dati vengono aggiornati quotidianamente. L’RTO può essere di diverse ore: la sua indisponibilità sarebbe un disagio, ma non bloccherebbe le operazioni core del business. Una semplice strategia di backup and restore è sufficiente ed economicamente efficiente.
Definire RTO e RPO è un esercizio di trade-off. Anche se downtime e perdita di dati prossimi allo zero sono tecnicamente raggiungibili, il costo è spesso proibitivo. Chiarire questi obiettivi fin dall’inizio assicura che gli sforzi engineering si concentrino sulla protezione di ciò che è davvero più prezioso per il business, con una strategia DR efficace e sostenibile.
Esplorare le principali architetture di Disaster Recovery nel cloud
Definiti RTO e RPO, il passo successivo è scegliere il pattern architetturale più adatto. Scegliere la strategia giusta per il disaster recovery nel cloud significa bilanciare velocità di ripristino, tolleranza alla perdita di dati e complessità implementativa rispetto ai vincoli di budget.
Ogni approccio si colloca su uno spettro di costo e prestazioni. La scelta ottimale dipende dalla criticità dell’applicazione. Questo albero decisionale mostra come la tolleranza del business verso downtime e perdita di dati si traduca in scelte architetturali specifiche.
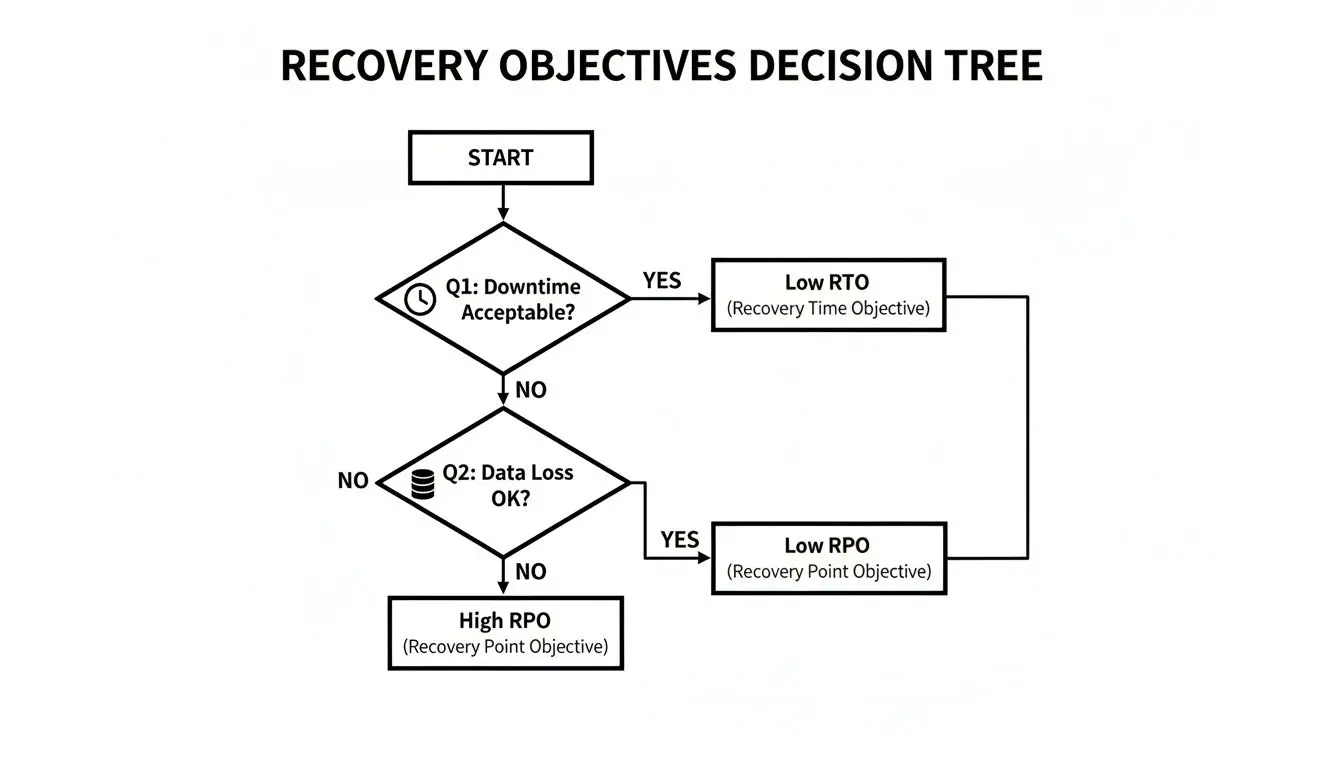
Come mostra il diagramma, una tolleranza elevata al downtime consente strategie più semplici e meno costose. Al contrario, i sistemi mission-critical con bassa tolleranza ai disservizi richiedono architetture più complesse e costose, capaci di garantire un ripristino quasi istantaneo.
Vediamo i quattro pattern principali, dal più essenziale al più resiliente.
Backup and Restore
Questa è l’architettura DR più basilare ed economica. Il principio è semplice: eseguire backup regolari dei dati e delle configurazioni applicative verso una destinazione sicura e geograficamente separata, in genere un’altra regione cloud. In caso di disastro, si provisiona un nuovo ambiente da zero e si ripristinano i dati da quei backup.
- Come funziona: snapshot automatizzati di database, macchine virtuali e object storage vengono creati a intervalli definiti. Durante il failover, gli engineer o gli script automatici provisionano la nuova infrastruttura e avviano il restore dai backup più recenti.
- RTO/RPO tipici: l’RTO si misura in ore o giorni, perché bisogna creare nuove risorse e ripristinare grandi volumi di dati. L’RPO dipende dalla frequenza dei backup; backup giornalieri comportano un possibile RPO fino a 24 ore.
- Più adatto a: sistemi non critici, ambienti di sviluppo e test, applicazioni interne in cui un downtime prolungato è accettabile.
Il principale compromesso è il tempo. È una soluzione economica da gestire, ma il recupero è lento e, tra questi pattern, è quella con il rischio più alto di perdita di dati.
Pilot Light
La strategia Pilot Light offre un equilibrio tra la lentezza del Backup and Restore e i costi più elevati degli approcci avanzati. Consiste nel mantenere nella regione di recovery una versione minima e ridotta dell’infrastruttura core. Questa “pilot light” è sempre attiva, ma non gestisce traffico di produzione.
L’analogia è quella di una stufa a gas: la fiamma pilota è sempre accesa, pronta ad accendere i bruciatori principali quando serve. In questa architettura, componenti essenziali come una piccola replica del database e un singolo application server restano in idle. Durante un disastro, l’infrastruttura viene scalata fino alla piena capacità produttiva.
Questo approccio riduce sensibilmente l’RTO rispetto al Backup and Restore, perché l’infrastruttura core è già stata provisionata. Il failover diventa un processo di scaling e reindirizzamento del traffico, non di costruzione da zero.
- Come funziona: un footprint minimo di infrastruttura, inclusa una replica del database, resta in esecuzione continua nella regione DR. I dati vengono replicati in modo asincrono dalla regione primaria.
- RTO/RPO tipici: l’RTO è in genere di pochi minuti fino a qualche ora. L’RPO può essere di secondi o minuti, a seconda della latenza di replica dei dati.
- Più adatto a: applicazioni business-critical in cui un RTO di diverse ore non è accettabile, ma non è giustificato il costo di un ambiente completamente duplicato.
Warm Standby
Un’architettura Warm Standby estende il concetto di Pilot Light. Invece di un core minimale, nella regione di recovery viene mantenuta una versione completa – ma inattiva – dell’ambiente di produzione. Il sistema è pronto a prendere il traffico quasi immediatamente.
Tutti i server, i database e i servizi sono in esecuzione e sincronizzati con l’ambiente di produzione, ma non servono richieste utente. La differenza chiave rispetto al Pilot Light è che durante il failover non serve scalare nulla: l’infrastruttura va solo attivata. La sfida tecnica principale è mantenere la consistenza dei dati tramite replica continua. Spesso il failover si riduce a un semplice cambio DNS.
- Come funziona: una copia completa e inattiva dell’ambiente di produzione gira in una regione separata, con replica continua dei dati.
- RTO/RPO tipici: l’RTO si riduce a pochi minuti. L’RPO è estremamente basso, spesso di pochi secondi.
- Più adatto per: servizi mission-critical, come piattaforme e-commerce o applicazioni SaaS core, dove un fermo ha un impatto economico diretto e rilevante.
Active-Active multi-regione
È l’architettura di disaster recovery più resiliente – e anche la più complessa – e garantisce tempi di fermo e perdita di dati prossimi allo zero. In una configurazione Active-Active, l’applicazione gira contemporaneamente in due o più regioni geografiche, con il traffico bilanciato tra esse. Entrambi gli ambienti sono attivi e servono utenti in tempo reale.
Se una regione va in fault, il traffico viene reindirizzato automaticamente verso le altre regioni sane, senza interventi manuali. Questa architettura elimina il concetto di “evento di failover”; un disservizio regionale viene gestito come un normale evento operativo. Tuttavia, questo livello di resilienza introduce una complessità tecnica e dei costi significativi.
- Sfide: gestire la replica dei dati e la consistenza tra database distribuiti geograficamente è una delle principali difficoltà ingegneristiche. Servono networking e routing del traffico sofisticati per indirizzare gli utenti verso la regione sana più vicina, mantenendo al tempo stesso località dei dati e consistenza.
- RTO/RPO tipici: sia RTO sia RPO sono prossimi allo zero.
- Più adatto per: applicazioni globali con i requisiti di uptime più stringenti, come piattaforme di trading finanziario o servizi consumer su larga scala, dove qualsiasi fermo è inaccettabile.
Confronto tra le architetture di disaster recovery nel cloud
Questa tabella mette a confronto, in modo sintetico, i compromessi tra le quattro strategie principali.
| Architettura | RTO tipico | RPO tipico | Costo relativo | Complessità di implementazione | Più adatto per |
|---|---|---|---|---|---|
| Backup e ripristino | Da ore a giorni | Da minuti a 24 ore | Basso | Bassa | App non critiche, ambienti dev/test |
| Pilot Light | Da minuti a ore | Da secondi a minuti | Medio | Media | App business-critical con tolleranza moderata al fermo |
| Warm Standby | Minuti | Secondi | Alto | Alta | Servizi mission-critical con forte impatto economico |
| Active-Active multi-regione | Prossimo allo zero | Prossimo allo zero | Molto alto | Molto alta | App globali in cui qualsiasi downtime è inaccettabile |
Come si vede, esiste una correlazione diretta tra costo, complessità e prestazioni di ripristino. Il punto chiave è allineare la scelta architetturale al valore di business dell’applicazione che deve proteggere.
Sfruttare l’automazione per un ripristino affidabile
Un piano di disaster recovery gestito manualmente è un piano destinato a fallire. Durante un incidente reale, il livello di stress è alto, gli engineer lavorano sotto forte pressione e la probabilità di errore umano aumenta in modo drastico. Affidarsi a documentazione statica e checklist manuali è la ricetta perfetta per prolungare il fermo e fallire i tentativi di recupero.
L’unica strada per un ripristino prevedibile, rapido e affidabile passa da automazione e orchestrazione. Trattando i processi di recovery come codice, li trasformi da piani astratti in sistemi testabili e ripetibili.
Dalle runbook statiche al codice eseguibile
La tradizionale runbook DR – un documento conservato in una wiki – è spesso obsoleta già al momento della creazione. I sistemi moderni evolvono troppo in fretta perché la documentazione manuale resti accurata. La soluzione è codificare l’intero processo di recovery.
Si parte dall’Infrastructure as Code (IaC). Strumenti come Terraform o AWS CloudFormation permettono di definire l’intero ambiente cloud – server, reti, security group, load balancer – in file versionati. In questo modo puoi predisporre, con un solo comando, un ambiente coerente e identico in una regione di recovery, eliminando drift di configurazione ed errori di setup manuale.
Un processo di recovery automatizzato non offre solo velocità, ma anche consistenza. Il codice si esegue nello stesso modo ogni volta, eliminando l’improvvisazione e il panico che compromettono gli interventi manuali durante un outage ad alto impatto.
Questo approccio trasforma di fatto la runbook in un insieme di script eseguibili, integrando il DR nella strategia CI/CD. Puoi approfondire questa integrazione nella nostra guida su come costruire una pipeline CI/CD robusta.
Automatizzare il failover e i controlli di salute
Oltre al provisioning dell’infrastruttura, l’automazione è decisiva per il processo di failover in sé. Ogni passaggio manuale introduce un potenziale punto di rottura. Queste attività dovrebbero essere scriptate e, dove possibile, automatizzate.
Le aree chiave per l’automazione includono:
- Failover DNS: servizi come AWS Route 53 o Azure Traffic Manager possono reindirizzare automaticamente il traffico verso una regione di recovery sana in base a controlli di salute configurabili. È il meccanismo principale per spostare il traffico di produzione con il minimo downtime.
- Promozione del database: gli script devono gestire la promozione di un database replica in sola lettura nella regione di recovery, facendolo diventare il nuovo master primario. È una procedura critica, da orchestrare con precisione per evitare corruzione dei dati.
- Validazione post-failover: una volta completato il failover, devono partire subito controlli di salute automatici per verificare che tutti i servizi siano operativi, connessi e in grado di servire correttamente il traffico, prima di dichiarare concluso il recupero.
I rischi nascosti dei passaggi manuali
Anche con una strategia di automazione solida, le minacce maggiori si nascondono spesso negli interventi manuali non documentati eseguiti da engineer sotto pressione. Queste correzioni “eroiche” durante un outage vengono documentate di rado e quasi mai sono ripetibili, creando una falsa sensazione di sicurezza per gli incidenti successivi.
Molte organizzazioni restano impreparate. Una percentuale elevata di aziende che utilizzano servizi cloud protegge con un piano DR valido meno della metà delle proprie applicazioni. Le principali criticità indicate sono la complessità dei sistemi, la disponibilità limitata del personale IT e la carenza di competenze.
Questi dati evidenziano quanto sia necessaria l’automazione. Inserendo automazione e testabilità nella tua strategia di disaster recovery nel cloud fin dall’inizio, passi da un approccio reattivo, basato sulla speranza, a una disciplina proattiva e guidata dall’ingegneria, in grado di offrire resilienza verificabile.
Validare il piano di recovery con test rigorosi
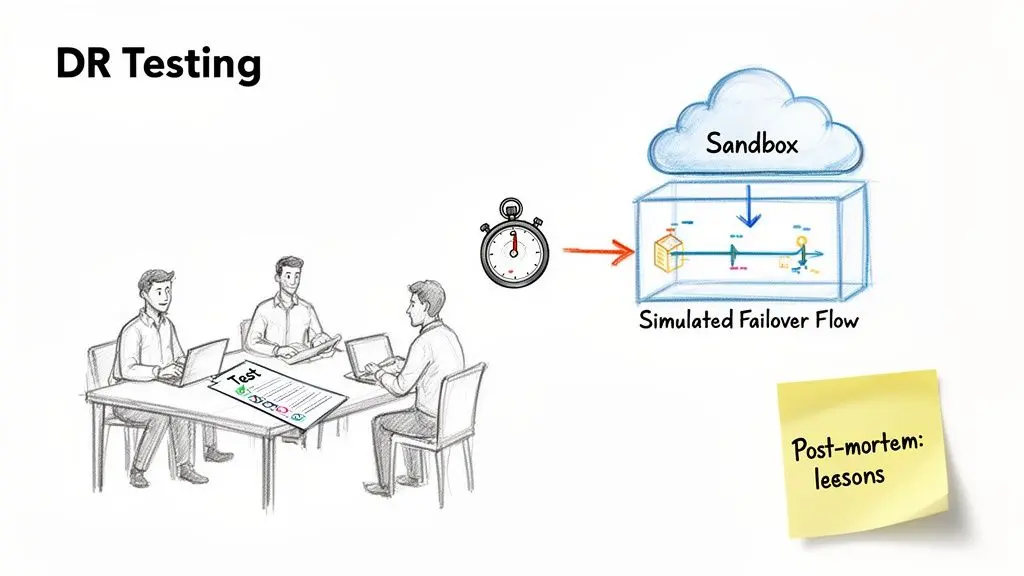
Un piano di disaster recovery che esiste solo sulla carta è una responsabilità, non un asset. È un’ipotesi non verificata sulla resilienza del tuo sistema. L’unico modo per trasformarla in una capacità affidabile è eseguire test regolari e rigorosi.
Senza una validazione, non hai alcuna garanzia che gli script automatici funzioneranno correttamente, che i backup dei dati siano davvero utilizzabili o che il team conosca ruoli e responsabilità durante una crisi. Per chi si occupa di compliance e per i responsabili di prodotto, un piano non testato è una minaccia diretta alla conformità normativa e alla fiducia dei clienti. Sul piano operativo, non è migliore dell’assenza di un piano.
Le implicazioni economiche sono enormi. I costi di downtime possono andare da migliaia a milioni di dollari all’ora. Ancora più importante, un numero significativo di aziende che subiscono un grave disastro sui dati senza un piano di recovery testato non riesce a restare sul mercato. Come approfondito in un’analisi di disaster recovery su Penncomp.com, i sistemi custom non testati portano spesso a ripristini lenti e backup corrotti.
Andare oltre il DR theatre
Una modalità di fallimento molto comune è il “DR theatre” – test superficiali che creano una falsa sicurezza. Questi esercizi, come il riavvio di un singolo servizio o un controllo di base sull’integrità dei dati, possono soddisfare un requisito di compliance, ma non simulano gli effetti a catena di un vero disastro.
Una validazione efficace richiede di spingere sistemi e team fino ai limiti operativi. Significa simulare guasti senza preavviso, testare dipendenze poco evidenti e verificare che ogni passaggio del recovery funzioni come progettato. L’obiettivo non è superare un test, ma individuare e correggere attivamente i punti deboli prima che un incidente reale li sfrutti.
Metodologie pratiche per un testing efficace
Un approccio maturo alla disaster recovery nel cloud adotta una strategia di test a più livelli. Invece di un unico grande esercizio annuale, i diversi tipi di test dovrebbero entrare nel normale ritmo operativo.
-
Tabletop exercise: sessioni strutturate, basate sulla discussione, in cui il team di risposta ripercorre uno scenario di disastro simulato. L’obiettivo è verificare la chiarezza della runbook, individuare lacune nella comunicazione e assicurarsi che tutti i partecipanti capiscano il proprio ruolo. È un metodo a basso rischio per testare la componente umana del piano.
-
Partial failover drill: in questi esercizi, si simula il guasto di un servizio o componente specifico in un ambiente non produttivo. Per esempio, il failover di una singola replica del database o di un application tier consente di validare script di automazione e dipendenze tecniche precise senza mettere a rischio la disponibilità della produzione.
-
Simulazioni complete: è il test più esteso, e prevede il failover completo dell’intero ambiente di produzione verso la regione di recovery. Pur essendo invasivo e impegnativo in termini di risorse, è l’unico modo per validare il processo end-to-end in condizioni realistiche. Queste simulazioni sono essenziali per i sistemi mission-critical e vanno pianificate con estrema cura.
Un test riuscito è quello da cui impari. Il post-mortem è la parte più preziosa dell’esercizio. Documenta ogni evidenza, aggiorna gli script di automazione e le runbook, e apri ticket per correggere i punti deboli individuati.
Una cultura di validazione continua è ciò che distingue le organizzazioni resilienti da quelle vulnerabili. Il testing non dovrebbe essere un appuntamento annuale da temere, ma una pratica ricorrente che costruisce una fiducia reale nella capacità di recovery.
Passare dalla pianificazione della resilienza alla realtà operativa
La disaster recovery nel cloud non è un progetto da chiudere, ma una qualità architetturale di base che va mantenuta nel tempo e allineata agli obiettivi di business. Un piano sulla carta non serve a nulla durante un vero outage; solo una capacità operativa comprovata può proteggere davvero la tua organizzazione.
Il processo inizia traducendo le esigenze di business in vincoli ingegneristici attraverso metriche RTO e RPO ben definite. Questi obiettivi guidano la scelta dell’architettura più adatta – da un modello Backup and Restore efficiente dal punto di vista dei costi a una configurazione Active-Active completamente resiliente – imponendo compromessi espliciti tra costo, complessità e velocità di recupero.
Abbracciare il miglioramento continuo
Tuttavia, una progettazione corretta è solo il punto di partenza. Senza automazione solida e test rigorosi e regolari, anche i piani migliori finiscono per degradarsi in teorie inaffidabili. L’automazione trasforma runbook statiche in codice eseguibile e ripetibile. Il testing verifica che sia i sistemi sia i team sappiano operare sotto pressione. Questo approccio sposta il DR da una configurazione una tantum a un ciclo di miglioramento continuo.
La vera resilienza non si ottiene scrivendo un piano, ma validando con costanza la capacità di recupero. Ogni test, che sia un tabletop exercise o una simulazione completa, è un’occasione per individuare e correggere i punti deboli prima che lo faccia un vero disastro per te.
L’obiettivo finale è andare oltre la semplice pianificazione e arrivare a uno stato di prontezza operativa costante. Questo approccio disciplinato, guidato dall’ingegneria, garantisce che i vostri prodotti digitali restino disponibili e affidabili, proteggendo sia i clienti sia il business. Per i responsabili tecnici, coltivare questa cultura è una componente critica della salute del sistema e della manutenibilità nel lungo periodo, in linea con i principi di miglioramento continuo che si vedono in come i progetti Kaizen mantengono i sistemi esistenti.
Domande frequenti
Risposte pragmatiche alle domande più comuni di leader tecnici e business su compromessi architetturali, costi nascosti e cadenze di test realistiche.
Come scelgo la giusta architettura di Disaster Recovery?
Non esiste una singola architettura “migliore”; la scelta è sempre un compromesso tra costo, complessità e obiettivi di RTO/RPO. Un approccio a livelli, basato sulla criticità dell’applicazione, è la strategia più efficace e anche più sostenibile dal punto di vista economico.
Classificate i vostri servizi:
- Sistemi mission-critical: includono servizi come i gateway di pagamento o l’autenticazione utente core, dove qualsiasi indisponibilità impatta direttamente ricavi e fiducia. Questi sistemi giustificano il costo di un’architettura Warm Standby o Multi-Region Active-Active per raggiungere un RTO quasi nullo.
- Applicazioni business-critical: sono servizi essenziali per le operazioni, ma in grado di tollerare interruzioni brevi. Un’architettura Pilot Light offre un equilibrio sensato tra velocità di ripristino e costo operativo per questa fascia.
- Sistemi non essenziali: strumenti interni, dashboard di analytics e ambienti di sviluppo raramente richiedono un ripristino immediato. Una strategia Backup and Restore semplice e a basso costo è sufficiente.
Allineando l’investimento in resilienza all’impatto sul business, potete costruire un piano DR efficace e sostenibile.
Quali sono i costi nascosti più rilevanti?
I costi più significativi, e spesso trascurati, nel DR cloud sono operativi, non infrastrutturali. Anche se la spesa mensile per le risorse inattive è prevedibile, altre voci possono pesare parecchio.
Tenete presenti queste tre aree:
- Overhead di engineering: le ore di lavoro necessarie per sviluppare, mantenere e testare gli script IaC, gestire la replica dei dati e tenere aggiornati i runbook rappresentano un costo importante e ricorrente. Questo carico cresce insieme all’evoluzione dei sistemi.
- Costi di data egress: il failover verso un’altra regione comporta il trasferimento di grandi volumi di dati attraverso la rete del cloud provider. Questi costi di uscita possono essere rilevanti e spesso non compaiono nei modelli di costo iniziali.
- Tassa della complessità: le architetture ad alta resilienza, soprattutto Active-Active, introducono una complessità significativa. Gestire lo stato e garantire la consistenza dei dati tra regioni distribuite geograficamente genera costi di engineering e manutenzione di lungo periodo, legati alla diagnosi e correzione di bug sottili tipici dei sistemi distribuiti.
Con quale frequenza dovremmo testare il nostro piano di Disaster Recovery?
La frequenza dei test dovrebbe essere coerente con il ritmo di cambiamento dei sistemi. Un’applicazione interna statica ha esigenze di test diverse rispetto a una piattaforma SaaS rivolta ai clienti con deploy settimanali.
Per i sistemi mission-critical, una cadenza ragionevole è eseguire esercitazioni di failover parziale ogni trimestre e una simulazione completa una volta all’anno. Questo ritmo costruisce fiducia operativa senza creare eccessiva discontinuità.
Un approccio più evoluto integra la verifica del DR nel ciclo di sviluppo. Qualsiasi cambiamento architetturale rilevante – come la sostituzione di un database o l’introduzione di un nuovo microservizio – dovrebbe attivare un test di ripristino mirato per il componente interessato. In questo modo i test smettono di essere un appuntamento annuale e diventano una pratica ingegneristica continua, garantendo che il piano DR resti allineato alla realtà del sistema.
Una strategia di disaster recovery solida è un pilastro di qualsiasi prodotto digitale affidabile. In Devisia, aiutiamo le organizzazioni a progettare e costruire sistemi resilienti e manutenibili, fondati su scelte architetturali pragmatiche e obiettivi di business chiari. Scoprite di più su come trasformiamo la visione in software affidabile su https://www.devisia.pro.