La Privacy by Design non è un esercizio di conformità: è una disciplina ingegneristica che porta la protezione dei dati dentro l’architettura stessa di sistemi e prodotti. Tratta la privacy come un requisito fondamentale, non come una funzionalità opzionale aggiunta a ridosso del rilascio.
Il problema: la privacy come catalizzatore del debito tecnico
Per molti team di prodotto, la privacy viene affrontata come un ostacolo di compliance da gestire nelle fasi finali. Questo approccio reattivo è una delle principali fonti di debito tecnico. Quando la privacy arriva solo alla fine, i team di engineering si ritrovano a dover fare refactoring costosi, a integrare soluzioni fragili e a lottare in continuazione per aggiungere nuove funzionalità senza violare le regole di trattamento dei dati. È qui che emergono le vulnerabilità e che la fiducia degli utenti si indebolisce.
Adottare la Privacy by Design cambia il modo di affrontare il problema. Sposta la protezione dei dati da tema legale a principio architetturale centrale. Il presupposto è semplice: una privacy solida non si può aggiungere dopo, va incorporata nel progetto del sistema fin dall’inizio.
Questo approccio proattivo crea vantaggi architetturali e di business molto concreti:
- Riduce il debito tecnico: costruire i controlli privacy fin dall’inizio evita le correzioni costose e invasive che penalizzano i team reattivi.
- Migliora la resilienza del sistema: un sistema progettato con la privacy come priorità è intrinsecamente più sicuro e robusto – è semplicemente meglio ingegnerizzato.
- Costruisce fiducia nei clienti: dimostrare un impegno reale nella protezione dei dati è un fattore di differenziazione forte, che favorisce la fidelizzazione.
- Semplifica la manutenzione: quando il trattamento dei dati è intenzionale e dichiarato chiaramente, l’intero sistema diventa più facile da capire, mantenere ed evolvere.
La logica economica della privacy proattiva
Trattare la privacy come un’attività a bassa priorità ha conseguenze finanziarie tangibili. Il costo medio globale di una data breach ha raggiunto i 4,88 milioni di dollari per singolo incidente.
E, dato ancora più rilevante, le organizzazioni con programmi maturi di Privacy by Design risparmiano in media 1,5 milioni di dollari per violazione rispetto a quelle con pratiche immature. Parliamo di una riduzione dei costi del 31%. Da questo punto di vista, la PbD non è una spesa di conformità, ma un investimento strategico nella resilienza finanziaria. Puoi trovare altri approfondimenti su questi risparmi nei costi delle violazioni su standardfusion.com.
La privacy non serve a limitare le funzionalità, ma a creare fiducia attraverso una buona ingegneria. Un sistema che protegge i dati degli utenti per impostazione predefinita è un sistema ben progettato, resiliente e pronto ad affrontare le sfide future.
I sette principi fondanti
Il concetto di Privacy by Design si basa su sette principi fondamentali formulati dalla dott.ssa Ann Cavoukian. Per software engineer e architect, non si tratta di ideali astratti, ma di linee guida operative per la progettazione del sistema e i flussi di sviluppo. Offrono un framework chiaro per costruire prodotti che rispettano gli utenti fin dall’inizio.
Tradurre i principi in pratica ingegneristica
| Principio | Concetto chiave | Applicazione pratica nello sviluppo software |
|---|---|---|
| 1. Proattiva, non reattiva; preventiva, non riparativa | Anticipare e prevenire i problemi di privacy prima che si presentino. | Eseguire Privacy Impact Assessment (PIA) già in fase di progettazione. Usare il threat modeling per i flussi di dati. |
| 2. Privacy come impostazione predefinita | Non serve alcuna azione dell’utente per proteggere la privacy: è integrata nel sistema. | Le impostazioni predefinite per la condivisione dei dati sono su “off”. La raccolta dei dati è minimizzata di default. Usare l’opt-in per il trattamento dei dati non essenziali. |
| 3. Privacy integrata nel design | La privacy è un componente centrale del sistema, non un’aggiunta successiva. | Integrare i controlli privacy direttamente nell’architettura dell’applicazione. La cifratura dei dati è una funzionalità nativa, non un livello separato. |
| 4. Funzionalità completa – logica win-win, non a somma zero | Conciliando gli interessi legittimi senza falsi compromessi. | Progettare sistemi che generano valore di business senza compromettere la privacy degli utenti. Rifiutare la falsa alternativa tra funzionalità e protezione dei dati. |
| 5. Sicurezza end-to-end – protezione lungo l’intero ciclo di vita | I dati sono protetti dalla raccolta fino alla distruzione. | Implementare la cifratura in transito e a riposo. Usare metodi sicuri di cancellazione dei dati. Applicare controlli di accesso rigorosi lungo tutto il ciclo di vita dei dati. |
| 6. Visibilità e trasparenza – mantenere tutto aperto | Gli stakeholder capiscono quali dati vengono raccolti e perché. | Fornire informative privacy chiare e sintetiche. Implementare dashboard per gli utenti per gestire dati personali e consensi. |
| 7. Rispetto della privacy dell’utente – centralità dell’utente | L’architettura e il design del sistema danno priorità agli interessi dell’utente. | Progettare flussi di consenso intuitivi e strumenti semplici per richiedere accesso o cancellazione dei dati. Mettere l’utente al controllo dei propri dati. |
Questi principi dimostrano che la privacy non è solo un’altra funzionalità da mettere in backlog. È un indicatore di qualità fondamentale per qualsiasi sistema ben progettato.
Integrare la privacy nel ciclo di vita dello sviluppo software
Una Privacy by Design efficace non è una checklist da eseguire una volta sola, ma una pratica continua integrata in ogni fase del ciclo di vita dello sviluppo software (SDLC). Richiede un cambiamento culturale: passare da una mentalità reattiva, del tipo “sistemiamo dopo”, a una disciplina ingegneristica proattiva in cui la privacy è un fattore di progettazione essenziale.
Questo approccio trasforma principi astratti in abitudini concrete e quotidiane per il team di engineering, spostando la privacy da ripensamento costoso a principio strategico di design.
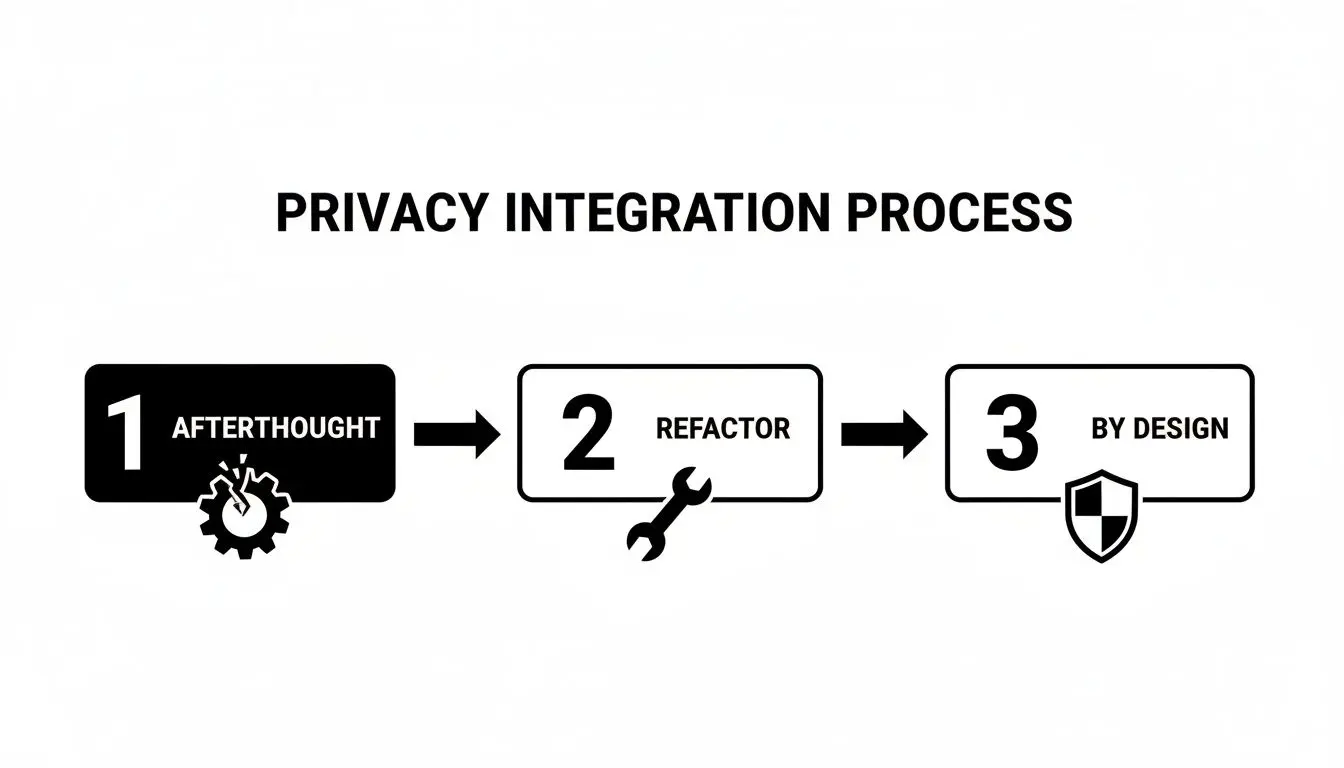
Le organizzazioni mature non tappano falle nella privacy: costruiscono sistemi in cui la privacy è parte integrante dell’architettura, ottenendo prodotti più resilienti e affidabili.
Discovery e design: la base critica
Questa fase iniziale è la più importante per implementare correttamente la Privacy by Design. Le decisioni prese qui hanno effetti a cascata su tutto il progetto. Il costo per correggere un difetto di privacy in questa fase è di ordini di grandezza inferiore rispetto a un intervento dopo il rilascio.
L’obiettivo principale è mappare come i dati personali fluiranno nel sistema proposto. Le attività chiave includono:
- Privacy Impact Assessment (PIA): un PIA è uno strumento strategico, non un esercizio di compliance. Eseguito prima di scrivere codice, consente di identificare e mitigare i rischi privacy, imponendo chiarezza su quali dati vengono raccolti, perché sono necessari e come verranno protetti.
- Data Flow Diagram (DFD): queste mappe visive tracciano il ciclo di vita dei dati personali, mostrando dove vengono raccolti, elaborati, archiviati e condivisi con servizi terzi. I DFD rendono concreti per tutto il team i principi, altrimenti astratti, del trattamento dei dati.
Per esempio, un DFD per una nuova funzionalità di analytics mostrerebbe gli identificativi utente che passano dall’applicazione client, attraversano una API, arrivano a un servizio di elaborazione e confluiscono in un data warehouse. Questo mette subito in evidenza possibili vulnerabilità, come dati in transito non cifrati o una conservazione eccessiva.
Sviluppo e architettura: implementare i controlli nel codice
Durante lo sviluppo, sono le decisioni architetturali a rendere concreta una postura di privacy. Il team di engineering traduce i requisiti definiti in fase di design in controlli robusti e automatizzati.
Le scelte tecnologiche sono decisive. Selezionare un database con cifratura nativa a livello di colonna o un provider di autenticazione con MFA integrata rafforza i controlli fin dall’inizio. L’architettura deve applicare principi come la minimizzazione dei dati.
Un anti-pattern molto comune è costruire sistemi che raccolgono una grande quantità di dati “nel caso potessero servire in futuro”. Questa pratica viola direttamente la minimizzazione dei dati e amplia inutilmente la superficie di rischio. L’architettura deve imporre la raccolta del solo indispensabile per il funzionamento della funzionalità.
Test e QA: verificare le protezioni
I controlli privacy vanno testati con la stessa accuratezza di qualsiasi altra funzionalità. Il processo di QA deve includere casi di test specifici, pensati per verificare che le misure di privacy funzionino come previsto e restino solide anche sotto stress.
Il piano di test dovrebbe coprire scenari come questi:
- Revoca del consenso: verificare che, quando un utente revoca il consenso, i suoi dati vengano esclusi in modo programmatico dalle attività di trattamento pertinenti, come campagne marketing o modelli di analytics.
- Richieste di cancellazione dei dati: testare che una Data Subject Access Request (DSAR) per la cancellazione rimuova completamente i dati dell’utente da tutti i sistemi, comprese basi dati primarie, cache, log e strumenti di terze parti.
- Validazione dei controlli di accesso: scrivere test per confermare che un utente con un certo ruolo non possa accedere a dati riservati a un altro ruolo. Un utente standard può accedere a un endpoint admin? Un utente può vedere i dati privati di un altro utente?
Deployment e manutenzione: vigilanza continua
Gli obblighi di privacy non finiscono con il deployment. L’ultima fase dell’SDLC richiede una vigilanza costante per garantire che le protezioni restino efficaci mentre il sistema evolve e compaiono nuove minacce.
Tutto parte da una gestione sicura della configurazione in fase di rilascio – cambiare le credenziali di default, chiudere le porte inutilizzate, rafforzare gli ambienti di produzione. Una volta online, il monitoraggio continuo è essenziale. Gli alert automatici devono avvisare il team in caso di possibili incidenti privacy, come pattern anomali di accesso ai dati o picchi nei tentativi di login falliti.
Infine, serve un processo ben documentato per gestire le richieste degli interessati. Quando un utente chiede di accedere ai propri dati o di cancellarli, il team deve avere un flusso chiaro per eseguire la richiesta in modo corretto e nei tempi previsti dalla legge. Questo processo va testato e raffinato con regolarità.
Pattern architetturali per la Privacy by Design
Passare dai principi all’implementazione richiede la scelta di pattern architetturali specifici. Sono le decisioni ingegneristiche concrete che costituiscono la base di un sistema privato e sicuro.
Fare le scelte giuste in questa fase è ciò che distingue un prodotto davvero resiliente da uno che si affida a una privacy policy solo di facciata.
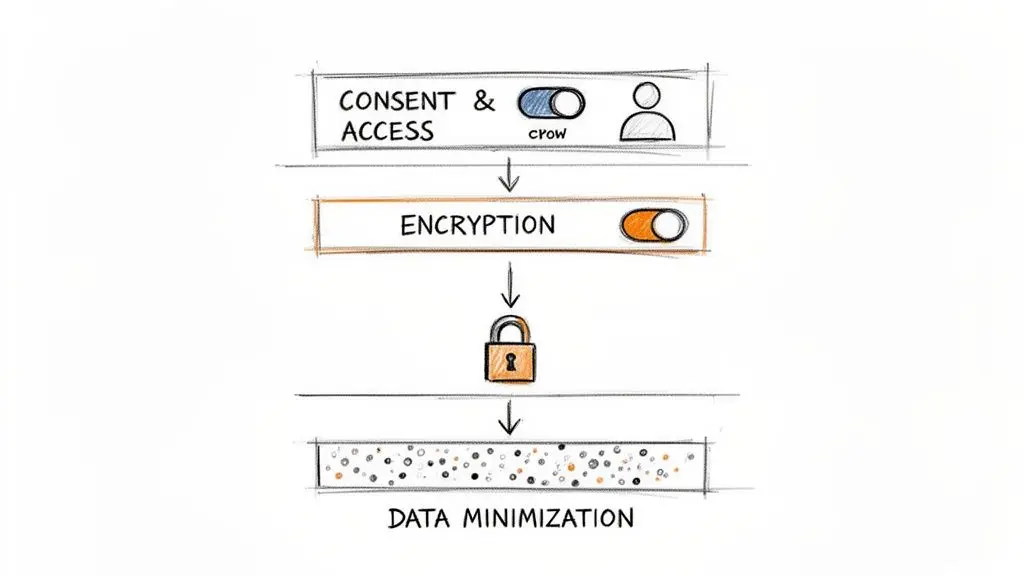
Vediamo i pattern fondamentali che abilitano la privacy by design, insieme ai relativi compromessi nel mondo reale.
Minimizzazione e anonimizzazione dei dati
Il modo più efficace per proteggere i dati è non raccoglierli. La minimizzazione dei dati è una disciplina architetturale che richiede una giustificazione per ogni singolo dato raccolto e archiviato. Contrasta direttamente la pratica ad alto rischio di raccogliere dati “nel caso servissero”.
Quando la raccolta è necessaria, anonimizzazione e pseudonimizzazione sono controlli secondari fondamentali. Spezzano il legame tra i dati e l’individuo, consentendo casi d’uso come l’analytics senza compromettere la privacy.
- Pseudonimizzazione: sostituisce gli identificativi diretti (per esempio nome, email) con un token coerente ma artificiale. Consente di tracciare l’attività di un utente senza esporre informazioni personali dirette. Il compromesso è la reversibilità: se la chiave di pseudonimizzazione viene compromessa, i dati possono essere ricollegati.
- Anonimizzazione: rimuove o modifica in modo irreversibile i dati, rendendo la re-identificazione computazionalmente impraticabile. Tecniche come la k-anonimity assicurano che un individuo sia indistinguibile da almeno altri k-1 soggetti, mentre la differential privacy aggiunge rumore statistico ai risultati delle query per proteggere i singoli record.
Il compromesso principale dell’anonimizzazione è tra utilità del dato e privacy. Un’anonimizzazione eccessiva può rendere i dati inutilizzabili per l’analisi; una insufficiente crea un falso senso di sicurezza. La tecnica scelta deve essere coerente con il profilo di rischio dei dati e con l’uso previsto. Le ricerche indicano che i sistemi costruiti secondo questi principi registrano fino al 60% in meno di data breach. Un case study condotto in un ospedale europeo ha mostrato una riduzione del 40% delle violazioni in due anni dopo aver integrato crittografia e anonimizzazione durante la riprogettazione di un sistema. Questo dimostra che quando si integra la privacy è importante quanto come. Puoi consultare i risultati completi di questa ricerca sull’efficacia della progettazione dei sistemi.
Confronto delle tecniche di anonimizzazione dei dati
Scegliere la tecnica giusta di anonimizzazione o pseudonimizzazione richiede di capirne punti di forza, limiti e casi d’uso più adatti. La tabella seguente confronta i metodi più comuni.
| Tecnica | Descrizione | Ideale per | Compromesso chiave |
|---|---|---|---|
| Pseudonimizzazione | Sostituisce gli identificativi diretti con token o alias coerenti. | Tracciare i percorsi utente o fare analisi longitudinali senza memorizzare direttamente i dati personali. | È reversibile. Se la chiave di mapping viene compromessa, i dati possono essere reidentificati. |
| Data Masking | Oscura campi di dati specifici sostituendoli con dati fittizi ma realistici. | Creare dataset realistici di test o sviluppo a partire dai dati di produzione. | Può essere complesso mantenere strutture e relazioni dei dati realistiche. |
| K-Anonymity | Garantisce che un individuo non possa essere distinto da almeno altri k-1 individui in un dataset. | Pubblicare dataset statistici o condividere dati con terze parti per attività di ricerca. | Può ridurre l’utilità dei dati, perché alcuni record potrebbero dover essere soppressi o generalizzati. |
| Differential Privacy | Aggiunge «rumore» matematico ai risultati delle query per proteggere la privacy individuale. | Analisi su larga scala e machine learning in cui la privacy individuale è prioritaria. | Il rumore aggiunto può influire sull’accuratezza delle query su dataset più piccoli. |
Nessuna tecnica, da sola, è una soluzione completa. I sistemi robusti spesso combinano più approcci in base alla sensibilità dei dati e al loro uso previsto, con l’obiettivo di rendere la reidentificazione praticamente impossibile e, al tempo stesso, preservare l’utilità necessaria dei dati.
Crittografia in transito e a riposo
La crittografia è un controllo di base, non negoziabile. Garantisce che, anche se i dati vengono intercettati o lo storage viene compromesso, le informazioni restino illeggibili senza le chiavi crittografiche appropriate. Questa protezione va applicata in modo universale.
La crittografia in transito protegge i dati mentre si spostano tra servizi, ad esempio dal browser di un utente al tuo server o tra microservizi interni.
- Best Practice: imposta TLS moderno (Transport Layer Security), in particolare TLS 1.2 o superiore, su tutti gli endpoint pubblici e le API interne.
- Errore comune: un errore frequente è terminare TLS al perimetro di rete (per esempio su un load balancer) e lasciare traffico non cifrato all’interno della rete interna «fidata». Se un attaccante ottiene un punto d’appoggio interno, questo crea una vulnerabilità significativa.
La crittografia a riposo protegge i dati archiviati nei database, nell’object storage o sui supporti di backup.
- Best Practice: utilizza la transparent data encryption (TDE) offerta dalla maggior parte dei database moderni (per esempio PostgreSQL, MySQL). Per i dati altamente sensibili, implementa la crittografia a livello applicativo, in cui i dati vengono cifrati prima di essere scritti nel database.
- Gestione delle chiavi: la sicurezza della crittografia dipende interamente dalla gestione delle chiavi. Usa un Key Management Service (KMS) dedicato, come AWS KMS o HashiCorp Vault. Non inserire mai chiavi di crittografia in chiaro nel codice applicativo o nei file di configurazione.
Per indicazioni su come strutturare servizi interni sicuri, consulta la nostra guida all’architettura service-oriented.
Consenso robusto e controllo degli accessi
Un’architettura deve essere in grado di far rispettare le promesse di privacy fatte agli utenti. Questo richiede due componenti chiave: un sistema solido di gestione del consenso e controlli di accesso granulari basati sul principio del privilegio minimo.
Una Consent Management Platform (CMP) è molto più di un banner dei cookie. Dal punto di vista architetturale, è un servizio centrale che registra le scelte degli utenti per le diverse attività di trattamento dei dati (per esempio marketing, analytics). Tutti gli altri servizi del sistema devono interrogare la CMP prima di eseguire un’azione pertinente.
Il Role-Based Access Control (RBAC) è il pattern standard per applicare il privilegio minimo. Garantisce che utenti e sistemi possano accedere solo ai dati e svolgere solo le azioni essenziali per la loro funzione.
- Implementazione: definisci ruoli chiari con permessi specifici e minimi (per esempio
support_agent,billing_admin,user). - Granularità: evita ruoli troppo ampi. Un operatore del supporto può aver bisogno di vedere la cronologia dei ticket di un cliente, ma non dovrebbe accedere ai dettagli di pagamento, a meno che non sia indispensabile per un’attività specifica e tracciata. L’architettura deve supportare questo livello di controllo granulare.
Sfide della privacy nei sistemi AI
L’intelligenza artificiale e il machine learning introducono una nuova classe di rischi per la privacy che le pratiche tradizionali di software engineering non coprono fino in fondo. I Large Language Model (LLM) non sono semplici database: apprendono, inferiscono e possono memorizzare informazioni sensibili in modi difficili da prevedere o controllare.
Applicare il privacy by design all’AI richiede un approccio specializzato.
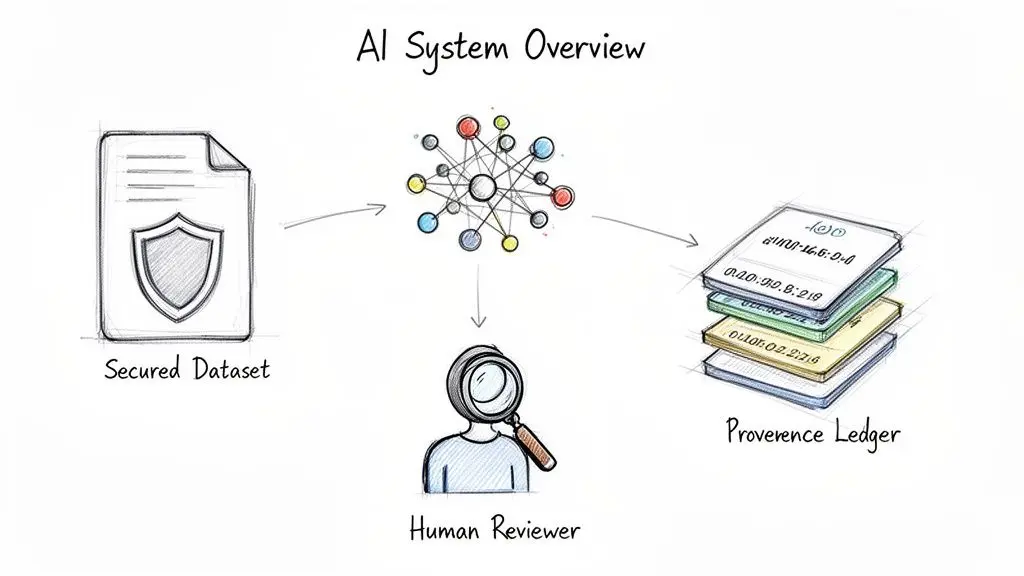
Anche se i metodi standard di protezione dei dati sono necessari, i sistemi AI richiedono ulteriori livelli di verifica. La natura del training e dell’inferenza dei modelli crea vulnerabilità specifiche, dai dati di addestramento contaminati fino a modelli che possono esporre accidentalmente informazioni personali.
Provenienza dei dati e sicurezza dei dati di training
L’integrità di un sistema AI dipende dai suoi dati di training. Senza una traccia verificabile dell’origine, della liceità e delle trasformazioni dei dati, il sistema poggia su fondamenta instabili. La provenienza dei dati è la disciplina che mantiene un registro dettagliato e verificabile del ciclo di vita di un dataset.
Non si tratta solo di un esercizio di compliance, ma di una misura concreta contro rischi tecnici seri. Per esempio, un modello addestrato con dati di provenienza impropria può essere vulnerabile a model inversion attacks, in cui un attaccante interroga il modello per ricostruire informazioni sensibili dal training set.
Una base dati robusta richiede:
- Audit di sourcing etico: verificare che i dati siano stati raccolti con il consenso corretto e per una finalità legittima.
- Registri immutabili: usare tecnologie come blockchain o object storage versionato per creare una traccia non alterabile del ciclo di vita dei dati.
- Controlli di accesso rigorosi: applicare il principio del privilegio minimo ai dataset di training, limitando l’accesso al personale e ai sistemi autorizzati.
Senza una provenienza solida, non è possibile rispondere a domande fondamentali sul comportamento o sui bias di un modello, con un rischio legale e reputazionale significativo.
Rischi per la privacy negli embedding e negli LLM
Un rischio sottile ma serio dell’AI moderna si trova nei modelli stessi. Gli LLM possono memorizzare e riprodurre involontariamente informazioni personali identificabili (PII) incontrate durante il training. Una query apparentemente innocua può spingere il modello a rivelare un nome, un indirizzo o altri dati privati.
Questo rischio aumenta con gli embedding – i vettori numerici che i modelli usano per rappresentare i dati. Questi vettori possono codificare in modo involontario attributi sensibili, creando una backdoor per la reidentificazione anche quando i dati grezzi sono stati sanitizzati.
Un modello non deve per forza memorizzare un indirizzo email esatto per violare la privacy. Se le sue rappresentazioni interne (embedding) raggruppano gli individui in base ad attributi sensibili dedotti, come lo stato di salute o la difficoltà finanziaria, il potenziale di abuso è enorme. È qui che il privacy by design per l’AI diventa critico.
Mitigare questi rischi richiede una difesa multilivello:
- Sanitizzazione aggressiva dei dati: prima del training, rimuovi in modo rigoroso dai dataset tutte le PII dirette e indirette. Questo include nomi, indirizzi e qualsiasi identificativo univoco che possa essere combinato per una reidentificazione.
- Filtraggio degli output e guardrail: implementa uno strato tra l’LLM e l’utente che analizzi gli output del modello per individuare eventuali PII prima della visualizzazione.
- Differential privacy nel training: per applicazioni ad alto rischio, adotta tecniche di differential privacy. Queste aggiungono rumore statistico durante il training per rendere matematicamente impraticabile la memorizzazione dei singoli punti dati da parte del modello.
Un approccio strutturato è essenziale per i team che sviluppano prodotti AI. Usa la nostra AI Risk & Privacy Checklist gratuita per valutare l’architettura del tuo sistema e individuare vulnerabilità specifiche.
Governance human-in-the-loop
Per applicazioni AI ad alto impatto, l’automazione completa può essere un rischio inaccettabile. Quando un’AI prende decisioni con un forte impatto sulle persone – in ambito finanziario, sanitario o legale – un’architettura Human-in-the-Loop (HITL) è essenziale per sicurezza, accountability e fiducia.
HITL è un pattern architetturale deliberato, in cui il sistema è progettato per demandare il giudizio umano nei punti critici. Questo fornisce una salvaguardia fondamentale contro errori del modello e conseguenze indesiderate.
Dal punto di vista architetturale, implementare HITL comporta workflow specifici:
- Soglie di confidenza: il modello elabora una richiesta e calcola un punteggio di confidenza. Se il punteggio scende sotto una soglia predefinita, il caso viene segnalato automaticamente per la revisione umana.
- Code di revisione: i casi segnalati vengono instradati verso un’interfaccia dedicata, dove un esperto umano può esaminare l’input del modello, l’output proposto e il contesto rilevante.
- Ciclo di feedback: la decisione dell’esperto – approvazione, rifiuto o modifica – viene registrata e reinserita nel sistema come dato di training per migliorare il modello nel tempo.
Questo approccio integra la governance direttamente nella funzionalità del sistema, trasformando un documento di policy in un processo vivo e operativo.
Definire la governance e misurare i risultati
I pattern architetturali e le integrazioni nel lifecycle sono il motore del privacy by design, ma la governance fornisce la direzione. Senza ownership chiara e metriche, anche le migliori implementazioni tecniche possono fallire. Una privacy sostenibile richiede un cambiamento culturale supportato da responsabilità chiare e verifiche continue.
Questo framework sposta la privacy da una serie di attività isolate a disciplina operativa centrale, garantendo che la responsabilità sia distribuita in tutta l’organizzazione.
Definire ruoli e responsabilità
Un’ownership ambigua è una delle cause di fallimento più comuni. Quando tutti sono responsabili della privacy, nessuno lo è davvero. Un programma duraturo richiede una definizione chiara dei ruoli.
- Data Protection Officer (DPO) o Privacy Lead: questo ruolo funge da hub strategico, facilita il processo, fornisce guida specialistica e agisce come riferimento principale per i regolatori. Per molte organizzazioni può essere una funzione part-time o esterna.
- Privacy Champion: sono engineer e product manager all’interno dei team di sviluppo che ricevono una formazione aggiuntiva. Fanno da prima linea di difesa, individuano in anticipo i potenziali problemi di privacy e promuovono le best practice nelle attività quotidiane.
- Leadership di prodotto e di engineering: il CTO e i responsabili di prodotto hanno la responsabilità ultima. Devono allocare il budget, far rispettare i controlli sulla privacy nelle approvazioni di progetto e sostenere il business case di una solida postura di privacy. È fondamentale definire con chiarezza chi risponde di cosa, come illustrato nella nostra guida pratica alla creazione di un codice di condotta per i team di engineering.
Verifica continua tramite audit e checklist
La governance deve essere un processo attivo e continuo. Servono meccanismi che garantiscano l’applicazione concreta dei principi di privacy.
Una checklist di rischio e privacy integrata in uno strumento di project management (ad esempio Jira, Asana) è una soluzione pragmatica. Prima che una nuova funzionalità possa essere segnata come “pronta per lo sviluppo”, il product owner deve completare la checklist, rispondendo a domande come:
- Quali nuovi dati personali raccoglie questa funzionalità?
- È stata condotta una Data Protection Impact Assessment (DPIA)?
- In che modo viene applicata la minimizzazione dei dati?
- I nuovi flussi di dati sono documentati e approvati?
Questo gate impone una conversazione consapevole sulla privacy prima che venga scritto il codice. Va affiancato a audit periodici sulla privacy – combinando scansioni automatiche del codice per individuare vulnerabilità come segreti hardcoded con revisioni manuali delle configurazioni di controllo degli accessi.
Lo scopo della governance non è creare burocrazia, ma introdurre attrito produttivo. Impone una pausa deliberata per valutare le implicazioni sulla privacy prima che diventino molto più costose da correggere.
Misurare ciò che conta
Per dimostrare valore e guidare il miglioramento, un programma di privacy deve essere misurato. La leadership ha bisogno di dati che mostrino il ritorno sull’investimento.
I dati evidenziano la posta in gioco: il 71% dei consumatori dichiara che smetterebbe di fare affari con un’azienda se questa condividesse dati sensibili senza autorizzazione. Negli ultimi tre anni le autorità di regolamentazione hanno comminato oltre 4 miliardi di dollari di sanzioni GDPR, trattando le violazioni come gravi fallimenti aziendali.
Le metriche chiave da monitorare includono:
- Riduzione degli incidenti di privacy: monitorare trimestralmente il numero di bug o vulnerabilità di sicurezza legati alla privacy che vengono segnalati.
- Tempo di risposta alle richieste degli interessati (DSR): tracciare il tempo medio necessario per soddisfare richieste di accesso o cancellazione dei dati. Una media in calo indica un miglioramento dell’efficienza dei processi.
- Tasso di completamento delle PIA: misurare la percentuale di nuovi progetti che completano una Privacy Impact Assessment prima dell’avvio dello sviluppo. Questa metrica valuta il rispetto del processo.
Queste metriche trasformano la privacy da ideale astratto a componente misurabile dell’eccellenza operativa, dimostrandone il valore per l’intero business.
Domande frequenti sulla Privacy by Design
Anche con una strategia chiara, emergono domande pratiche. Ecco i quesiti più comuni di founder, CTO e responsabili di prodotto che adottano un modello privacy-first.
Non è semplicemente conformità al GDPR?
No. La conformità al GDPR è un obiettivo normativo, spesso affrontato in modo reattivo. La Privacy by Design è una filosofia di engineering proattiva che integra la protezione dei dati nel cuore dei sistemi fin dall’inizio.
Sebbene il PbD sia una componente chiave del GDPR (codificata nell’articolo 25), il suo obiettivo è più ampio: creare sistemi intrinsecamente affidabili e resilienti, non solo conformi. Un sistema conforme può comunque avere debolezze architetturali; un sistema progettato con la Privacy by Design è, per natura, più robusto.
È troppo costoso per una startup?
L’investimento iniziale in pianificazione e architettura è nettamente inferiore al costo a lungo termine dell’inazione. Cercare di aggiungere controlli sulla privacy a posteriori in un prodotto già in produzione è esponenzialmente più costoso e complesso che progettarli fin dall’inizio.
Un approccio ingenuo genera debito tecnico, disservizi operativi e possibili violazioni dei dati, con costi ben superiori all’investimento iniziale. Per una startup, costruire su fondamenta orientate alla privacy è un vantaggio competitivo che rafforza la fiducia dei clienti ed evita sanzioni catastrofiche o danni reputazionali.
Il costo di un singolo intervento urgente di refactoring per correggere un difetto di privacy emerso dopo il rilascio supererà quasi certamente il costo della pianificazione iniziale.
Rallenterà il nostro sviluppo?
È una preoccupazione comune nei team agile. All’inizio, adottare pratiche come le Privacy Impact Assessment (PIA) e il threat modeling richiede un cambio di mentalità e può aggiungere tempo alla fase di discovery.
Tuttavia, una volta che queste pratiche diventano routine, smettono di essere un collo di bottiglia. Nel lungo periodo, spesso aumentano la velocità riducendo bug di sicurezza, patch d’emergenza e refactoring complessi che bloccano lo sviluppo. L’approccio concentra il ragionamento critico all’inizio, per evitare rilavorazioni costose più avanti.
Qual è il primo passo pratico che possiamo fare?
Partite dalla minimizzazione dei dati. È l’azione iniziale più semplice ed efficace.
Prima della prossima sessione di sprint planning, mettete in discussione ogni nuovo dato che intendete raccogliere. Chiedete al team: “Abbiamo davvero bisogno di questo dato, in questo momento, perché la funzionalità funzioni?”
Questa singola domanda impone una conversazione critica e aiuta a costruire le abitudini giuste. Non richiede nuovi strumenti né cambiamenti di processo rilevanti, ma riduce subito la superficie di rischio. È il punto di partenza con il massimo impatto e il costo più basso.
Costruire software sicuro, privato e manutenibile è il centro del nostro lavoro. In Devisia trasformiamo la vostra visione di business in prodotti digitali e sistemi AI affidabili, con la privacy come scelta architetturale, non come ripensamento a posteriori. Scopri di più sul nostro approccio pragmatico allo sviluppo software custom.